Привет самохостятам и им (нам) сочувствующим! Помогите разобраться с проблемой.
Proxmox PVE 8.4.16, Proxmox PBS 3.4.8.
Когда-то давно в целях на посмотреть как оно работает и сливать файлики из ВМ и контейнеров на отдельный жесткий внутрь PVE поставил PBS. Поигрался, настроил, бекапы исправно делались и верифицировались пару лет (все мы знаем про временное решение и постоянное, да?). Сегодня ночью PBS прислал письмо с ошибкой.
Details
| VMID | Name | Status | Time | Size | Filename |
|---|---|---|---|---|---|
| 102 | OMV | err | 1s | 0 B |
Total running time: 1s
Total size: 0 B
Logs
vzdump 102 --compress zstd --storage PBS1 --mailnotification always --quiet 1 --mode suspend --notes-template '{{guestname}}' --node prox --mailto usg@3947354.ru
102: 2026-10-07 00:00:01 INFO: Starting Backup of VM 102 (qemu)
102: 2026-10-07 00:00:01 INFO: status = running
102: 2026-10-07 00:00:01 INFO: backup mode: suspend
102: 2026-10-07 00:00:01 INFO: ionice priority: 7
102: 2026-10-07 00:00:01 INFO: VM Name: OMV
102: 2026-10-07 00:00:01 INFO: include disk 'sata0' 'raid:vm-102-disk-0' 8G
102: 2026-10-07 00:00:01 INFO: include disk 'sata1' 'raid:vm-102-disk-1' 32G
102: 2026-10-07 00:00:01 INFO: suspending guest
102: 2026-10-07 00:00:01 INFO: creating Proxmox Backup Server archive 'vm/102/2026-10-06T21:00:01Z'
102: 2026-10-07 00:00:01 ERROR: VM 102 qmp command 'backup' failed - backup connect failed: command error: write failed: No space left on device (os error 28)
102: 2026-10-07 00:00:01 INFO: aborting backup job
102: 2026-10-07 00:00:01 INFO: resuming VM again after 0 seconds
102: 2026-10-07 00:00:01 INFO: resume vm
102: 2026-10-07 00:00:02 ERROR: Backup of VM 102 failed - VM 102 qmp command 'backup' failed - backup connect failed: command error: write failed: No space left on device (os error 28)
Бекап делался на отдельный 8 ТБ жесткий диск, от которого было “откушено” половина под файловую систему и свободно на этом разделе около 70%.
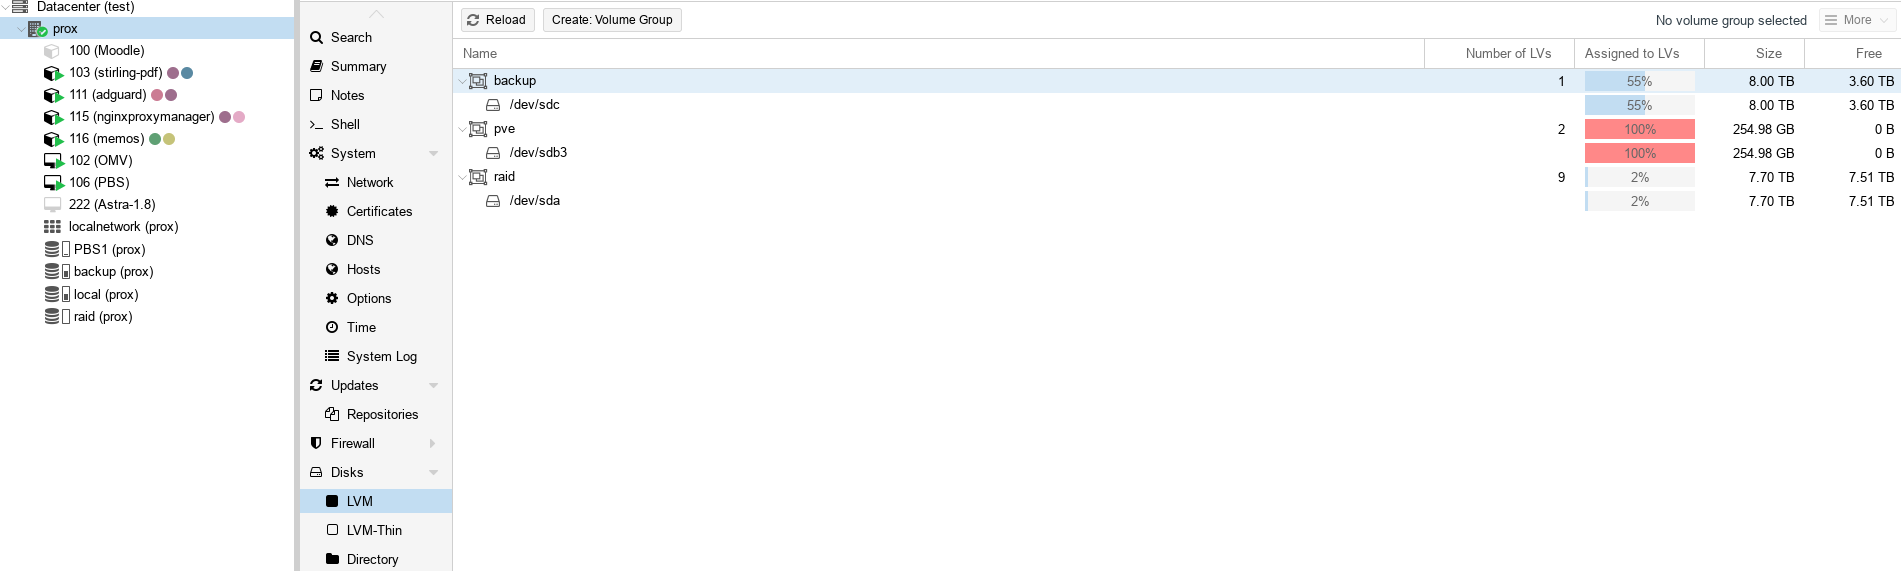
Забитый в ноль носитель нашел один, sdb3, на нем сам PVE установлен. Но в дереве слева раздел local заполнен только на половину. Все виртуалки и контейнеры висят в разделе raid. И бекап делается не них.
Если залезть в настройки самой ВМ, то там отражены все бекапы и хранилищем указан нужный PBS.
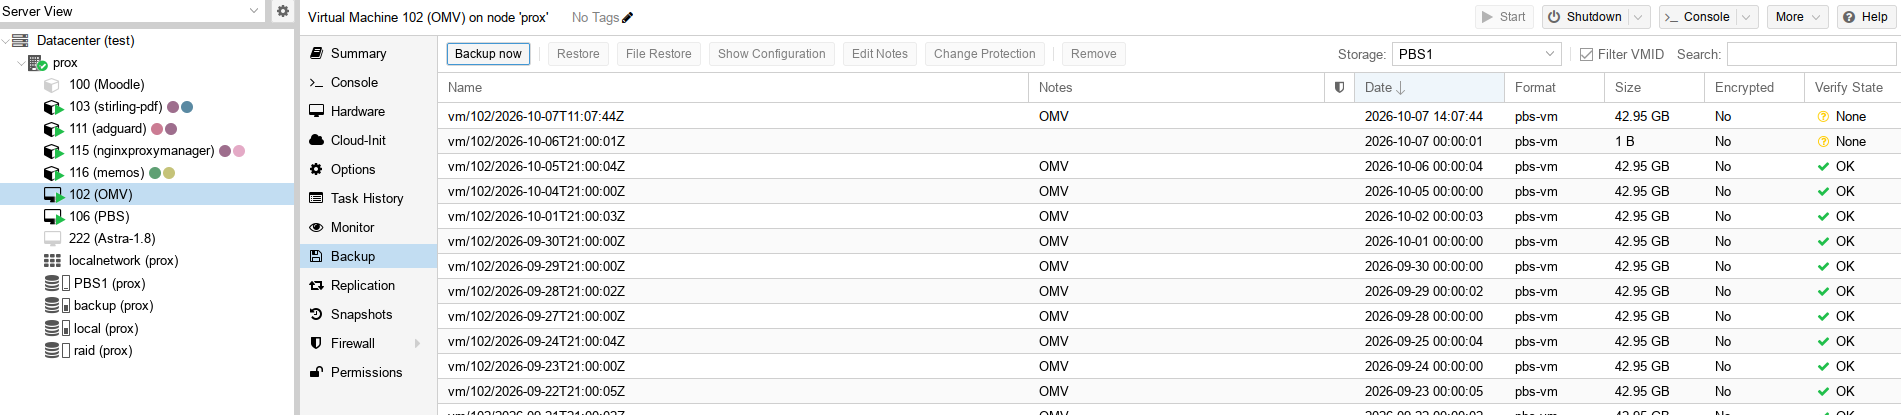
Утром, к слову, бекапы от 05.10 и 06.10 были неверифицированы. Сейчас статус поменялся, потому что вручную запустил верификацию. Она завершилась с ошибкой, в PBS для этой виртуалки Verify State висит “779 OK”, у остальных “ALL OK”.
2026-10-07T13:46:18+03:00: SKIPPED: verify back:vm/101/2023-08-29T21:00:58Z (recently verified)
2026-10-07T13:46:18+03:00: percentage done: 59.64% (2/5 groups, 54/55 snapshots in group #3)
2026-10-07T13:46:18+03:00: SKIPPED: verify back:vm/101/2023-08-29T13:44:24Z (recently verified)
2026-10-07T13:46:18+03:00: percentage done: 60.00% (3/5 groups)
2026-10-07T13:46:18+03:00: verify group back:vm/102 (780 snapshots)
2026-10-07T13:46:18+03:00: verify back:vm/102/2026-10-06T21:00:01Z - manifest load error: unable to load blob ‘“/mnt/datastore/back/vm/102/2026-10-06T21:00:01Z/index.json.blob”’ - No such file or directory (os error 2)
2026-10-07T13:46:18+03:00: percentage done: 60.03% (3/5 groups, 1/780 snapshots in group #4)
2026-10-07T13:46:18+03:00: verify back:vm/102/2026-10-05T21:00:04Z
2026-10-07T13:46:18+03:00: check qemu-server.conf.blob
2026-10-07T13:46:18+03:00: check drive-sata1.img.fidx
2026-10-07T13:47:37+03:00: verified 13875.08/15980.00 MiB in 78.46 seconds, speed 176.83/203.66 MiB/s (0 errors)
2026-10-07T13:47:37+03:00: check drive-sata0.img.fidx
Запущенный вручную бекап был успешно сделан. Повторная верификация поменяла Verify State для это ВМ на “780 OK”.
В чем вопрос. Что происходит с сервером? Почему он посчитал, что на каком-то (кстати, как бы выяснить на каком?) носителе не хватает места? Насколько это опасно для данных виртуалки? Как не допустить подобных ошибок в будущем?