Самохостятам привет!
Не знаю, буду ли записывать видео про это, но решил сделать пару заметок.
Дисклеймер1
автор не является экспертом в направлении AI, выражает свое восприятие мира, не претендуя на 100% правильность
Дисклеймер2
Если меня попросить описать в двух словах, а чем это отличается от chatgpt?
Уровни развития AI(в моей голове):
– LLM
языковые модели с которыми мы можем вести диалог в виде чата, ограничены своии знаниях тем, чему их научили в момент тренинга модели
— LLM+RAG
мы научились дообучать и давать моделям наши базы знания
---- LLM + MCP TOOLS
появились инструменты, вот тебе email_tool, модель может по запросу в чате - найти у себя инструмент и используя его сделать какие-то действия, от проверки почты до поиска и ресерча в сети
------ LLM AGENTS(например OpenClaw)
уже могут работать более автономно, умеют управлять VM\физической средой\работать с файлами , имеют доступы к базовым операциям: найти файл, создать новый, прочитать логи, поискать в сети, прочее + имеют из коробки широкий спектр инструментов, можете просто их дообучать и прописывать им знания в файлы .MD
---------- LLM AGENTS v2 (например Hermes)
пришло cамообучение.. * *У меня получилось со второй попытки помочь\выполнить задачу - преобразую это в SKILL #X. Узнал новое о пользователе - запишу себе в память. Сами правят свои MD файлы
Hermes
Hermes Agent — это автономный ИИ-агент с открытым исходным кодом, разработанный исследовательской лабораторией Nous Research. В отличие от обычных чат-ботов или дополнений для написания кода (копилотов), Hermes Agent работает постоянно на вашем сервере, ПК или в облаке, обладает долгосрочной памятью и способен самостоятельно обучаться и создавать новые навыки в процессе решения задач.
Ключевые особенности и возможности
- Самообучающийся цикл (Learning Loop): Агент не просто помнит контекст беседы, он анализирует свои успешные действия и автоматически формирует «документы навыков» в открытом стандарте
agentskills.io, которые использует в будущем. - Долгосрочная память: Хранит профиль пользователя, его предпочтения и детали проектов локально на вашем устройстве, избавляя от необходимости каждый раз заново объяснять контекст.
- Изолированная среда выполнения: Поддерживает 6 различных бэкендов для безопасного запуска терминальных команд и кода (локально, Docker, SSH, Daytona, Singularity, Modal).
- Кроссплатформенный доступ (Gateway): Агент может жить на сервере, но общаться с вами через интерфейсы CLI, десктопное приложение или ботов в более чем 20 мессенджерах (Telegram, Discord, Slack, WhatsApp и др.).
- Широкий набор инструментов: Из коробки поддерживает поиск в веб, автоматизацию браузера, чтение изображений (computer vision), генерацию картинок и озвучку текста (TTS). Также поддерживает интеграцию с любыми серверами протокола MCP (Model Context Protocol).
- Конфиденциальность: Полное отсутствие телеметрии и скрытого сбора данных.
Как установить?
- Windows\MacOS дестопные приложения берем с оф. сайте
- Linux, macOS, WSL2, Termux
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash- Proxmox LXC helper скриптами
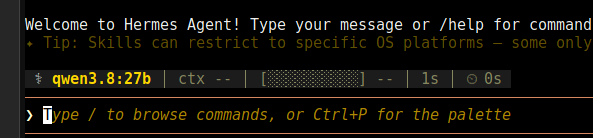
Запускаем, подключаем к локальной ollama
и вот у Вас локальный помощник, который по команде идет и
- чатает логи
- создает файлы
- запускает сервисы
- ходит по ssh
- …много вобщем всего…
скорость - чистой воды зависимость от Вашего железа..
вот пример, amd 780m igpu, 4 минуты.. не быстро.. но справился..
*что такое сходи домой - агент уже себе записал, понимает куда идти

Доп. полезности
1. Как дать агенту видеть все модели ollama?
По умолчанию - перезапускать seup и выбирать модель там.. неудобно..
завершив базовую настройку
идем в ~/.harmes/config.yaml
внизу ищем
custom_providers:
  - name: ollama_local
    base_url: http://192.168.1.175:11434/v1
    model: gpt-oss:20b
    tools: true
- просто добавляем “s” в слове model => models
- сохранить и перезапустить агента
теперь по команде /model видна не 1 модель, а все доступные на вашем сервере


2. Все ли модели ollama подходят?
Нет, у моделей должна быть поддержка инструментов(tools)

Ну и если модель совсем маленькая(читай глупая), то даже наличие отвертки в кармане - не дает возможность осознать, как ей закрутить шуруп..
Спотыкаются и ничего не делают
Что можно попробовать на слабом железе?
3. Выдал ip\login\password и попросил пойти ssh, а он говорит ошибка авторизации, просит проверить сервер, но там все работает корректно?
На слабых модельках, по понятным причинам, мысли они не всегда выражают верно, но спустя время - вы узнаете, что по паролю авторизация даже в режиме /yolo - запрещена.
Решается переходом на использование ключей
Способы стандартные, один из:
ssh-keygen -t ed25519- генерируете на вашей машине с агентом ключssh-copy-id root@192.168.1.36- копируете его на целевую машину
агент сможет авторизацию пройти используя ключ на этой машине.
 ?
